生成AI時代の分析
生成AIの発展により、データ分析のあり方も大きく変わりつつあり、データ分析は生成AIの得意領域の一つとも言われるようになりました。
特にテキストデータの分析では、生成AIの高い文脈理解力によって、従来の一般的なテキストマイニングでは難しかった文章の意味や文脈を踏まえた分析が容易になっています。自然言語で指示するだけで、データの内容を把握し、分類や要約、解釈を行うことができるようになりました。
一方、テキストデータ分析には、文章の内容を理解するだけでなく、特定の事象がどの程度存在するのか、どのような属性で特徴的なのか、複数の要素がどのように関係しているのかなど、データの傾向や構造を定量的に把握する分析もあります。このような分析では、テキストマイニングや統計解析、機械学習などの数理的な分析手法が有効です。
本ページでは、生成AIがどのような仕組みでデータを分析しているのかを確認したうえで、テキストデータ分析を対象として、生成AIによる分析と数理的分析がそれぞれどのような分析に適しているのかを整理します。さらに、両者を組み合わせることで、テキストデータからより深い知見を導き出すための分析アプローチと、生成AI時代に求められる分析設計について解説します。
生成AIはどのようにデータを分析するのか
生成AIによる文章生成の仕組み
まずは、生成AIがどのような仕組みで文章を生成しているのか確認します。現在の生成AIの中核となっている技術の一つが、LLM(Large Language Model:大規模言語モデル)です。LLMは、Transformerと呼ばれる技術を基盤として、大量のテキストデータなどを事前に学習した言語モデルです。
LLMの基本的な学習では、膨大な文章データを使い、それまでに入力された文章の文脈に基づいて次に続く単語を予測する訓練を繰り返します。その過程で、個々の単語の意味を高次元のベクトルとして表現し、単語同士の関係性や並びのパターンを学習することで、文脈上の複雑なニュアンスを捉えた高い表現力を獲得します。こうした大規模な学習を通じて、LLMは優れた文脈理解力を身につけ、入力された文章の内容に応じた適切な文章を生成できるようになります。
生成AIはこの高い文脈理解力によって、文章の要約、分類、質問への回答、情報の抽出など、従来のテキストマイニングでは難しかった柔軟な言語処理が可能になりました。
→ LLMの仕組みとテキストマイニングとの違いについて詳しく見る
生成AIによるデータ分析の仕組み
生成AIのLLMは本質的には数値計算を行う計算機ではなく、入力された文章の内容に対して、それに続く適切な文章を出力するモデルです。そのため、文章の意味を読み取ったり自然言語で回答したりすることには優れていますが、厳密な件数集計や複雑な数値計算をLLM自体に行わせることには適していません。
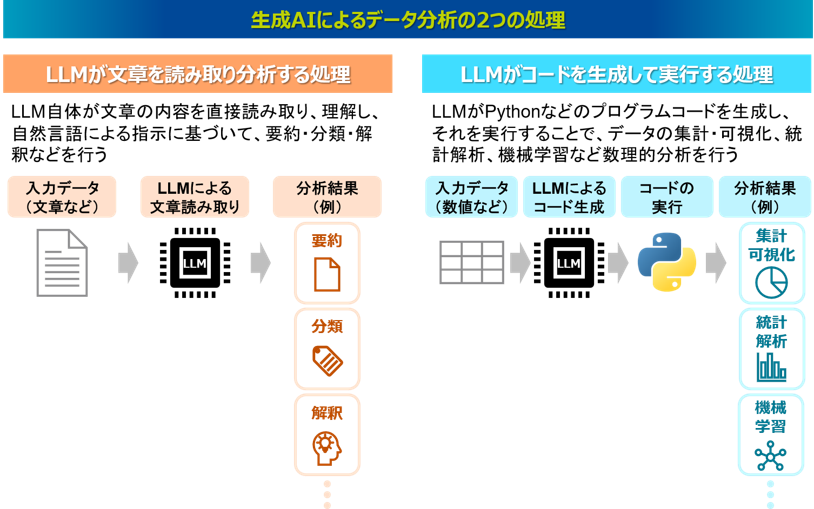
それでは、なぜ現在の生成AIはデータ分析も得意とされているのでしょうか。現在の生成AIによるデータ分析には、大きく分けて2つの処理があります。一つは、LLM自体が文章の内容を読み取り、要約・分類・解釈などを行う処理です。もう一つは、LLMがPythonなどのプログラムコードを生成・実行し、データの集計・可視化、統計解析、機械学習などを行う処理です。
LLMは自然言語だけでなくプログラムコードも大量に学習しているため、ユーザーが自然言語で分析内容を指示すると、その処理に必要なプログラムコードを生成することができます。また、コードを実行できる環境を備えた生成AIでは、生成したプログラムを実際に実行することで、本来LLM自体が苦手とする数理的分析を行うことができます。
つまり、「生成AIはデータ分析が得意」と一言でいっても、データ分析のすべての処理をLLM自体が行うわけではありません。文章の意味を読み取る処理はLLMが担い、厳密な数値計算が必要な処理はPythonなどのプログラムを生成することで、生成AIは幅広いデータ分析に対応できるようになっています。したがって、広い意味では、数理的分析も生成AIを介して実行できる分析の一つといえます。
一方、生成AIがプログラムコードの生成によって数理的分析もできるとはいえ、生成AIが文章の意味を直接読み取って、要約・分類・解釈などを行う分析とでは、分析方法としての特性が異なります。
そこで本ページでは、それぞれの分析方法の特長を比較するため、テキストデータを生成AIが直接読み取り、自然言語による指示に基づいて分析結果を導くアプローチを「生成AIによる分析」、統計解析や機械学習などのアルゴリズムによってデータを数理的に処理するアプローチを「数理的分析」として区別します。生成AIがプログラムコードを生成して数理的分析を実行する場合は、後者の「数理的分析」として扱います。なお、本ページでは、テキストデータから単語を抽出・集計し、それらを構造化データとして定量的に分析するテキストマイニングについても「数理的分析」として扱います。
テキストデータを対象とした生成AIによる分析と数理的分析
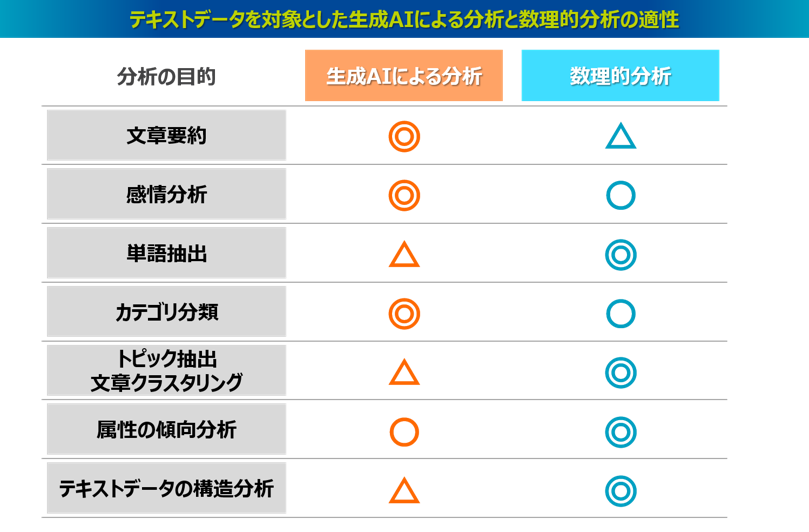
テキストデータの分析と一言でいっても、その目的はさまざまです。大量の文章に何が書かれているのかを把握したい場合もあれば、文章をカテゴリに分類したい場合、データの中から未知のトピックを発見したい場合、さらに文章の内容と顧客属性やKPIとの関係を定量的に把握したい場合などもあります。ここでは、代表的な7つの分析を対象として、生成AIによる分析と数理的分析について、それぞれの適性と課題を比較します。
なお、以下の評価は分析が「できる・できない」を示すものではなく、それぞれの分析方法を適用した場合の適性を示しています。
◎:非常に適している
○:適している
△:条件によって適性が異なる
×:適用には課題がある
(1)文章要約
人間ではすべてを読み切ることが難しい大量のテキストデータについて、どのようなことが書かれているのか、その要点を把握するための分析です。
生成AI:◎
文章要約は、生成AIが特に得意とする処理の一つです。生成AIは文章の文脈を踏まえて重要な内容を判断できるため、単純に文章を短くするだけでなく、目的に応じた形式で内容を整理できます。例えば、問い合わせ対応履歴から主要な問い合わせ内容と回答を抽出し、FAQの形式に整理するといった処理も可能です。また、要約の観点や粒度、出力形式を自然言語で指定できるため、目的に応じて柔軟に結果を変更できます。
数理的分析:△
テキストマイニングでは、文章を単語に分解して頻出語や特徴語などを抽出することで、文章群にどのような内容が含まれているのかを把握できます。しかし、単語の頻度だけでは文章全体の文脈や具体的な内容まで捉えることは難しく、文章そのものを自然な形で要約する用途では生成AIに大きな利点があります。
(2)感情分析
文章に表現されている感情や評価を判定する分析です。ポジネガ分析とも呼ばれます。アンケートの自由記述やWEBの口コミ、コールセンターの問い合わせなどを、ポジティブな内容とネガティブな内容に分けて分析する場合などに利用されます。
生成AI:◎
生成AIは文章全体の文脈を踏まえて判断できるため、単純なポジティブ・ネガティブの表現だけでなく、二重否定や文脈依存の表現など、単語単位では判定しにくいニュアンスも考慮した分類が可能です。また、「ポジティブ/ネガティブ」だけでなく、「満足」「不満」「要望」「困惑」など、分析目的に応じて分類軸を柔軟に設定することもできます。
数理的分析:○
従来から、単語辞書を利用した判定方法や教師あり学習による判定方法などがあります。辞書ベースの方法は、テキストマイニングの機能の一つとして利用されることが多いですが、単語ごとに付与された「ポジティブ/ネガティブ」の極性値などに基づいて判定するため、高速かつ一貫した基準で大量の文章を処理できます。一方、文章全体の文脈や微妙なニュアンスを考慮する必要がある場合には、単語単位の判定だけでは十分に捉えられないことがあります。また、教師あり学習の方法では、事前に相当程度のデータを人間が判定する必要があります。
(3)単語抽出
文章群に具体的にどのような単語が登場しているのかを抽出する分析です。文章を要約するのではなく、頻出キーワードなどを列挙することでデータ全体の特徴を把握します。
生成AI:△
生成AIに文章から重要な単語や表現を抽出させることは可能です。また、「商品に関する表現だけを抽出する」「不満を表す表現を抽出する」など、意味に基づいて柔軟に抽出条件を設定できる点には利点があります。一方、すべての文章から同一の基準で単語を抽出し、大量の文章について正確な出現件数を集計するといった処理では、形態素解析などの専用技術を利用する方が適しています。
数理的分析:◎
単語抽出は、テキストマイニングが特に得意とする処理です。形態素解析によって文章を一定の基準で単語に分割し、高速かつ一貫した処理ができます。また、単語の原形への変換、不要語の除外、類義語辞書を利用した表記ゆれの統合などを行うことで、大量のテキストデータから単語を体系的に抽出し、その出現頻度を正確に集計できます。
(4)カテゴリ分類
各文章に対して、あらかじめ指定したカテゴリに該当するかどうかを判定し、ラベルを付与する分析です。例えばホテルの口コミであれば、「価格」「部屋」「朝食」「アクセス」といったカテゴリを用意し、それぞれの口コミがどのカテゴリについて記述しているのかを判定します。これによって、雑多なテキストデータを分析しやすい形に分類できます。
生成AI:◎
生成AIは文章の文脈を踏まえてカテゴリを判定できるため、カテゴリに対応する単語をすべて事前に定義しなくても分類できます。例えば「価格」というカテゴリの場合、「価格」という単語そのものが含まれていなくても、「高い」「安い」「割引」「クーポン」「値上げ」といった表現や、文章全体の文脈から価格に関する話題であることを判断できます。また、カテゴリの定義や判定基準を自然言語で指定できるため、分析目的に応じて分類基準を柔軟に設計できることも大きな特長です。
数理的分析:○
感情分析と同様に、従来から単語辞書を利用した分類方法や教師あり学習による分類方法などがあります。辞書ベースの分類では、それぞれのカテゴリに対応する単語群を定義し、その単語が文章に含まれているかどうかによってラベルを付与します。この方法は判定ルールが明確で、大量の文章を同一の基準で高速に処理できる一方、対象となる表現をあらかじめ網羅的に定義する必要があります。特に、単語そのものは一致していなくても、文脈上は同じ話題をしている文章を幅広く分類するには限界があります。
(5)トピック抽出・文章クラスタリング
既に定義されたカテゴリ分類とは異なり、大量の文章について、どのようなトピックが存在しているのか、どのようなグループに分類できるのかを事前に定義できない場合に、データそのものからトピックやグループを探索する分析です。例えば、大量の特許文書から、どのような要素技術が存在しているのかを把握したい場合、あらかじめすべてのカテゴリを定義することは困難です。そこで、トピックモデルやクラスタリングなどを利用することで、特許文書全体から特徴的な技術トピックを探索できます。
生成AI:△
生成AIに対して、それぞれの文章がどのようなテーマについて記述されているのかを回答させることはできます。そのため、個々の文章の内容を解釈し、トピック名を付与すること自体は得意です。一方、カテゴリを事前に定義せず、大量の文章全体から互いに整合したトピック体系をゼロから安定的に構築する用途では課題があります。文章ごとに自由にトピック名を生成させると、類似した内容に異なる名称が付いたり、トピックの粒度が揃わなかったりして、多数のトピックが生成される可能性があります。そのため、生成AI単独でトピック体系を構築するよりも、数理的な方法によって文章群を一定の基準でまとめ、その結果の解釈やトピック名の付与に生成AIを利用するといった組み合わせが有効です。
数理的分析:◎
トピックモデル、クラスター分析、次元削減などの教師なし学習を利用することで、大量の文章を一定の数理的基準で分類し、データ全体に存在する主要なトピックやグループを探索できます。文章を単語の出現頻度によって表現したデータや、文章の意味をベクトル化した埋め込み表現などを利用することで、人間が事前にカテゴリを設定していない状態から、データに存在する特徴的な文章群を抽出できます。一方、モデルやパラメータの設定によって結果が変化するほか、抽出されたトピックに複数の内容が混在したり、意味の近いトピックが重複したりする場合があります。そのため、結果を確認しながら調整することが重要です。
(6)属性の傾向分析
テキストデータに性別や年代、商品、地域、企業などの属性情報が紐づいている場合に、それぞれの属性でどのような内容が記述される傾向があるのかを分析します。単に文章全体の記述内容を把握するだけでなく、「どの顧客層で」「どの商品で」「どの企業で」といった、属性の条件別に記述傾向を把握するため、マーケティング戦略や他社との競争戦略など、施策検討につながる分析です。
生成AI:○
例えば、投稿者の属性(性別・年代など)が紐づいたホテルの口コミデータについて、生成AIに男性と女性でそれぞれ特徴的な内容を要約させることで、「男性では価格に関する記述が目立つ」「女性では朝食に関する記述が目立つ」といった定性的な特徴を把握できます。一方、「価格に関する記述は男性では女性の何倍出現しているのか」「その差はどの程度大きいのか」といった定量的な傾向の強さを厳密に評価するには、集計や統計解析が適しています。生成AIによる自然言語の説明は直感的に理解しやすいという利点がありますが、施策の優先順位を判断するためには、その傾向がどの程度強いのかを定量的に把握することも重要です。
数理的分析:◎
形態素解析によって生成された「文章×単語」のデータや、トピックモデルなどによって生成された「文章×トピック」のデータを属性情報と組み合わせることで、「単語×属性」「トピック×属性」の関係を定量的に分析できます。例えば、特定のトピックの出現率を属性間で比較したり、統計的な検定によって差を評価したりすることで、「どの属性で、どの話題が、どの程度特徴的なのか」を定量的に把握できます。
(7)テキストデータの構造解析
属性の傾向分析では、「単語×属性」「トピック×属性」のように1対1の要素間の関係を分析します。これに対して構造解析では、単語やトピック、属性情報など複数の要素を同時に扱い、それらの間にどのような複合的な関係構造が存在しているのかを分析します。例えば、あるトピックが「性別」「年代」「利用目的」などの複数の属性とどのように関係しているのかを分析することで、そのトピックが出現しやすい条件の組み合わせを探索できるので、よりターゲットを絞ったマーケティング施策などを検討できます。また、アンケートの顧客満足度や口コミの評点のようなKPIとなる情報が存在する場合には、KPIとどのような単語・トピック・属性が関係しているのかを分析することで、KPI改善に向けて着目すべき要素を探索できるので、経営課題の解決に向けた意思決定につながります。あるいは、単語群と単語群、トピック群とトピック群という関係構造を分析するパターンもあります。例えば、特許文書から用途に関するトピックと技術に関するトピックを抽出し、用途と技術の関係構造を分析することで、用途実現に向けた解決技術を把握したり、保有技術の新規用途を探索するなど、研究開発の技術戦略などを検討できます。
生成AI:△
属性の傾向分析と同様に、「価格の話題が多い顧客にはどのような特徴があるか」「満足度の高低にはどのような要素が関係しているか」といった質問を生成AIに与えれば、文章の内容から定性的な特徴を整理することはできます。一方、単語・トピック・属性・KPIなど多数の要素間に存在する関係を俯瞰的に探索し、その関係の強さや複合条件による違いを定量的に評価することは、生成AIが文章を直接読み取る分析には適していません。
数理的分析:◎
テキストデータから抽出した単語やトピック、それらに属性情報やKPIなどを組み合わせ、それぞれを変数として扱うことで、決定木やベイジアンネットワークといった構造を分析できる数理モデルを適用します。例えばベイジアンネットワークでは、目的変数と説明変数を固定的に区別することなく、それぞれの変数が互いにどのような関係を持っているのか、その確率的な依存関係をネットワーク構造として表現できます。これによって、あるトピックの出現がどのような属性と複合的に関係しているのか、その関係の強さを定量的に把握するとともに、それらの属性の組み合わせ条件が変化した場合に、トピックの出現確率がどの程度変化するのか探索できます。また、KPIを含めてモデル化すれば、KPIと各要素の関係構造を把握し、特定の条件下でKPIが高くなる確率や、KPIが高い傾向を示す条件の組み合わせを探索できます。
ここまで、テキストデータの分析目的ごとに生成AIによる分析と数理的分析の適性を比較してきました。両者の違いを端的に整理すると、生成AIによる分析は、文章の「意味や文脈を読み取ること」に優れ、「自然言語による分析の指示や結果の生成」といった高い柔軟性があります。一方、数理的分析は、テキストデータを「単語やトピックといった要素を軸に持つ構造化された数値データ」に変換し、それをアルゴリズムで処理することで、文章に存在する要素の「量・関係・構造を測ること」に優れていると考えることができます。つまり、テキストデータ分析における生成AIと数理的分析の適性は、分析の目的によって異なります。文章を要約・分類・解釈する分析では生成AIが大きな力を発揮する一方、件数を正確に集計したり、文章に潜むトピックをゼロから安定的に抽出したり、属性別の傾向や複数の要素の関係構造を定量的に分析したりする場合には、テキストマイニングや統計解析、機械学習などの数理的分析が適しています。
重要なのは、すべての分析を生成AIに任せることでも、従来から存在する数理的分析だけを使い続けることでもありません。それぞれの特長を理解し、「分析によって何を明らかにしたいのか」に応じて適切なアプローチを設計することです。
生成AIと数理的分析を組み合わせる
生成AIと数理的分析は、それぞれ異なる特長を持つため、分析目的に応じて適材適所で使い分けることは重要ですが、さらに両者を相互補完的に組み合わせることで、それぞれ単独の適用では得られにくい知見を導き出すことができます。ここでは、生成AIと数理的分析を組み合わせてテキストデータを分析するアプローチを紹介します。
生成AIで意味を捉え、数理的分析で傾向を測る
生成AIの大きな利点の一つは、文章の意味を柔軟に読み取り、それをカテゴリやラベルとして構造化できることです。例えば、「価格に関する話題」を分析したい場合、辞書ベースの分析では、「価格」「料金」「高い」「安い」「割引」「クーポン」など、価格に関連する単語を事前に定義し、それらの単語が含まれているかどうかによってカテゴリを判定する方法が一般的です。生成AIを利用すれば、「価格に関する話題が含まれているか」という自然言語による指示によって、個別の単語をすべて指定しなくても文章の文脈からカテゴリを判定できます。
この判定結果を「価格カテゴリ該当=1/非該当=0」のような構造化データに変換すれば、その後は数理的分析によって、価格に関する話題が何件存在するのか、どの属性で多いのか、満足度などのKPIとどの程度関係しているのかを分析できます。つまり、非構造化された文章の意味を、数理的に分析できる構造化データへ変換するために生成AIを利用することができます。
数理的分析で着目すべき対象を絞り、生成AIで内容を深掘りする
反対に、数理的分析によって重要な対象を絞り込んだ後、その具体的な内容を生成AIで読み解くことも有効です。例えば、ホテルの口コミを数理的に分析した結果、「男性」と「価格に関する話題」の間に、また「女性」と「朝食に関する話題」の間に強い関係が見つかったとします。数理的分析ではこうした属性別の傾向の強さを把握することはできます。しかし、それだけでは、男性が価格について、女性が朝食について、それぞれ具体的に何を評価し、何に不満を感じているのかまでは分からないので、具体的な施策を検討するためには、さらに内容を掘り下げる必要があります。
そこで、「男性」かつ「価格に関する話題」に該当する口コミを抽出し、その文章群を生成AIに分析させれば、例えば、「会員限定の割引特典に魅力を感じている」「駐車料金への不満が多い」といった具体的な内容まで掘り下げることができます。「女性」かつ「朝食に関する話題」に該当する口コミでも同様に、例えば、「種類を増やしてほしいという要望がある」「オーガニック野菜の料理への評価が高い」といった具体的な声に気づくことができます。
課題解決に向けた意思決定では、まず「どの課題を優先すべきか」を判断するための定量的な情報が重要です。一方、具体的な施策を検討する段階では、その課題について「具体的に何が語られているのか」を詳しく理解する必要があります。先の例では、生成AIによる深堀分析により、例えば、会員特典に駐車料金の無料化も追加する、朝食にオーガニック野菜のサラダバーを設けるといった施策が考えられるかもしれません。そして、それぞれの施策を反応しやすいと考えられる顧客層をターゲットに設定してPRするといったマーケティングも検討できます。
また、特許文書などのように内容の細かい違いが重要となるテキストデータでは特にこの組み合わせの分析は効果があります。例えば、半導体製造に関する特許文書を対象にトピックを抽出したところ、シリコンウエハの表面に絶縁膜や金属導電膜などの薄い膜を張る「成膜技術」のトピックが抽出され、それと関係の強い企業にA社とB社があったとします。これだけでは、A社とB社はいずれも「成膜技術」に関連する特許が特徴的であることまでは分かりますが、両社の具体的な技術の違いまでは把握できません。そこで、それぞれの会社の「成膜技術」に該当する特許群を生成AIで分析させれば、両社の技術の違いをより詳しく把握できるようになります。例えば、A社は大量のウエハを一括で成膜するバッチ式の技術が特徴的で、B社は1枚ずつ高精密に成膜する枚葉式の技術が特徴的である、といった違いが分かるかもしれません。こうした違いの把握は、研究開発における競争戦略やM&A・技術提携などの戦略を検討するうえでも重要です。
このように数理的分析によって「どこを見るべきか」を絞り込み、生成AIによって「そこで何が起きているのか」を読み解くことで、定量的な優先順位付けから具体的な施策検討までをつなげることができます。
数理的分析の結果を生成AIで解釈・補完する
生成AIは、数理的分析によって得られた結果を解釈する用途にも活用できます。
例えば、文章に存在するトピックをゼロから抽出する場合には、トピックモデルやクラスタリングなどの教師なし学習が有効です。こうした数理的分析では、抽出されたトピックの特徴語とその定量的な重みを把握できます。しかし、その情報だけからそのトピックがどのような意味を持つのか、解釈が難しいことがあります。また、同じトピックに複数の意味が混在したり、意味の近いトピックが複数に分かれたりする場合もあります。
そこで、数理的分析によって抽出されたトピックの特徴語やトピックに該当する文章群を生成AIに読み込ませることで、それぞれのトピックの意味を解釈する補助として活用できます。また、意味が混在するトピックや類似するトピックについても、生成AIで改めて分類を柔軟に加工・整理することもできます。特に特許文書などの専門性の高いテキストデータでは、数理的分析の結果だけでは意味を解釈しにくい場合があり、生成AIによる解釈補助の効果は大きいです。
このように数理的分析だけでは難しい柔軟な意味づけや分類を生成AIで行い、さらにその結果を再び数理的分析へ戻し、生成AIと数理的分析を反復的に組み合わせることで、より解釈性に優れた分析を進めることができます。
生成AI時代に求められる分析設計
冒頭で解説したように、生成AIは文章の意味や文脈を直接読み取るだけでなく、プログラムコードを生成・実行することで数理的分析にも活用できます。さらに、複数の分析工程を連続して実行し、分析プロセスそのものを自動化するエージェント型の技術開発も進められています。こうした技術によって、データ分析の多くの処理を生成AIで効率化・自動化できる可能性は、今後さらに広がっていくと考えられます。
一方、当社では、生成AIで分析を効率化することと、分析プロセス全体を一括して自動化することは、分けて考える必要があると考えています。実際のデータ分析では、最初に設計した分析方法をそのまま最後まで実行すれば、必ず有用な結果が得られるとは限りません。途中の分析で得られた結果によって、次に実行すべき分析が変わり、分析方法を再設計することも少なくありません。
例えば、テキストマイニングで抽出された単語から数理的分析を実行するための構造化データを作成する際、すべての抽出単語をその後の分析に採用するわけではありません。抽出単語の一覧を確認して、分析のノイズになりかねない不要語を選定して除外します。また、トピックを抽出する分析も、設定条件によって得られるトピックが異なりますが、どの粒度のトピックだと現場の課題感に合うのかは、結果を確認してみないと判断できません。再度設定条件を変更してトピックを抽出し直すということもあります。また、トピックと属性との関係を分析する際も、どのような特徴が現れるのかは分析してみないとわかりません。当初は想定していなかった特徴が見つかり、そこから新たな仮説を立て、その特徴を詳しく調べるために新たな分析を追加することもあります。
このように、データ分析は「設計→実行→結果の確認・解釈→再設計」という反復的なプロセスによって進めることがあります。生成AIは、この各工程を支援し、分析の実行や結果の解釈だけでなく、分析方法や可視化の提案などにも活用できます。当社でも、生成AIによって効率化できる処理には積極的に活用していきます。一方、当社では、一連の分析プロセスを最初から最後まで一括して生成AIに委ねるのではなく、分析の途中で得られた結果を確認し、その結果が分析目的に対して何を意味するのかを解釈しながら、必要に応じて次の分析を設計することを重視しています。想定していた結果が得られなければ、分析方法や分析の切り口そのものを見直す。分析によって新たな特徴や関係が見つかれば、それを詳しく調べるための分析を追加する。このように、分析結果を次の分析設計へフィードバックし、重要な判断をしながら分析を再設計することで、より課題の解決に資する知見へと段階的に近づけていきます。
生成AIによって「分析を実行する」ための技術的なハードルが下がるほど、「何を明らかにするために、何をどのように分析し、それをどのように活用するのか」という分析設計の重要性はますます高まります。生成AIを分析プロセスに取り入れながら、課題に応じて分析方法を設計し、得られた結果を確認しながら次の分析へつなげ、最終的に意思決定に必要な知見を導き出す。これが、生成AI時代に当社が重視するアナリティクスデザインです。
